 羽落天青 | Uke's Blog
笔记花园
DQN
2026-06-15
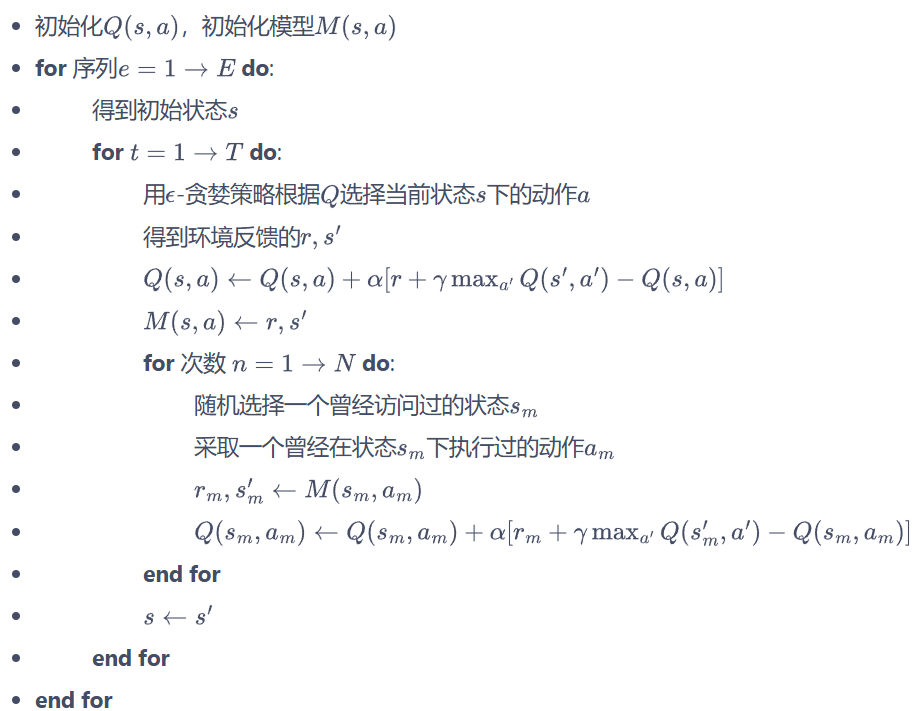
在先前的Sarsa Q-learning and Dyna-Q算法中,我们始终需要维护一张Q(s,a)的表格,而这在state的数量巨量或者直接为离散情况时,这是不现实的
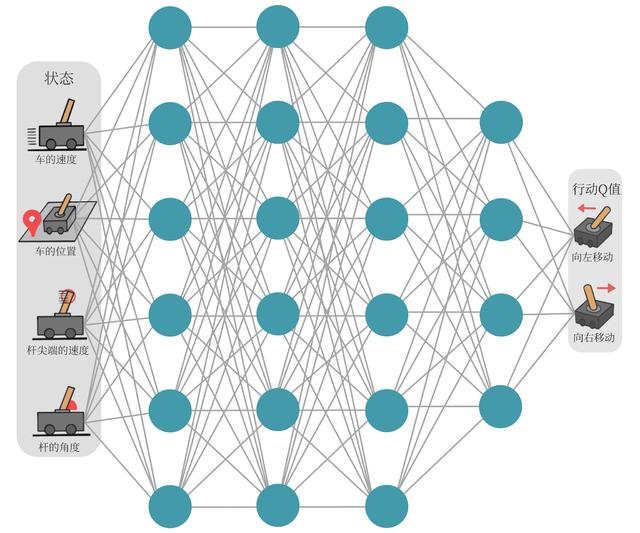
于是我们尝试用函数来拟合这个表格
从深度学习的学习之中,我们知道,多层感知机是一种很好的拟合函数
今天介绍的DQN算法便可以用来解决这样的情况,我们把函数记为Q_\omega(s,a)
我们把这样的网络记为Q-网络
965 字
|
5 分钟
REINFORCE&ACTOR_CRITIC
2026-06-15
先前我们所涉及的所有算法,都是针对价值函数进行迭代,而策略方面往往仅局限于\epsilon-\text{贪婪算法},几乎不进行更新
我们先介绍基于策略的经典算法:REINFORCE,也就是策略梯度算法
639 字
|
3 分钟