 羽落天青 | Uke's Blog
1.自然扩展
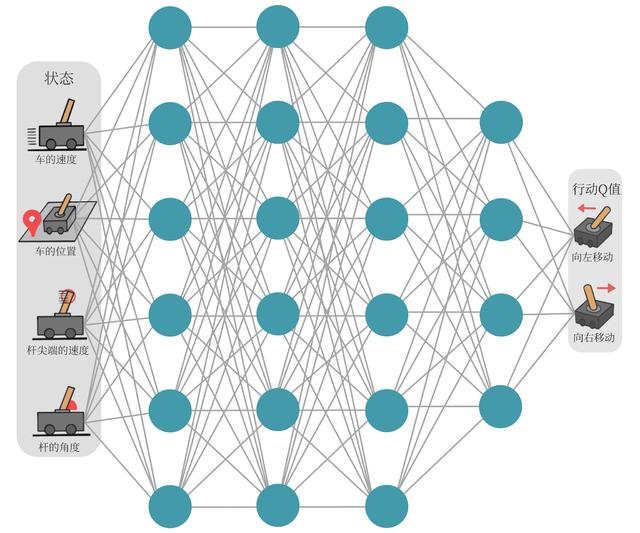
在先前的Sarsa Q-learning and Dyna-Q算法中,我们始终需要维护一张的表格,而这在的数量巨量或者直接为离散情况时,这是不现实的 于是我们尝试用函数来拟合这个表格 从深度学习的学习之中,我们知道,多层感知机是一种很好的拟合函数 今天介绍的DQN算法便可以用来解决这样的情况,我们把函数记为 我们把这样的网络记为Q-网络
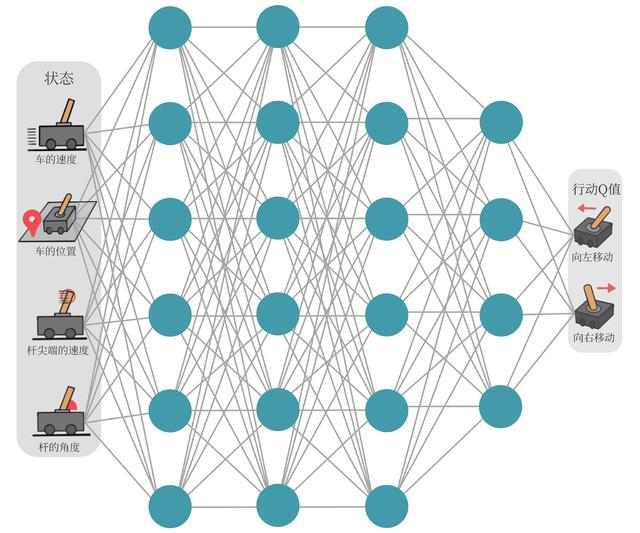 我们沿用Q-learning的更新准则:
当Q逐渐收敛到某个具体值时,会逐渐收敛到0
因此,很自然的,我们将Q网络的损失函数定义为:
2.经验回放和目标网络
以上均很自然,可如果完全使用TD的更新方法,学习率近乎为0 原因有二:
- 始终使用时间连续,前后相关的数据,不满足数据的相互独立,会出现过拟合
- 损失函数的目标始终在变动,也许会导致正反馈式的自举现象,那么就可能很难收敛,甚至出现无限增长的现象
2.1 经验回放
为了解决(1),我们引入了经验回放 也就是我们采样环境之后,我们维护一个经验缓冲区,存储四元组 每次从缓冲区中随机取样 这不仅解决了(1)的问题,还降低了与环境交互的次数,也就降低了成本
2.2 目标函数
为了解决(2),我们引入了目标网络,也即维护两个Q网络:
- 原有的网络,
- 目标网络, 其中,正常更新,而每隔步与同步,即:
3.DQN的改进
3.1double DQN
每次都筛选最大的Q来自举更新会最终导致整个网络的Q都被严重抬高 于是: 从网络中选择argmax,但是用来更新,有效抑制Q爆炸,提升网络的稳定性
3.2 dueling DQN
将原本Q的更新拆成两块 其中,A命名为优势函数 V与A分别共用一部分神经网络,并分别分立一部分参数 但当然,如果如此建模,V+C A-C,不会使得Q值改变,也就是说不唯一 我们减去,此时满足唯一性,且满足贝尔曼最优方程 但是max不具备鲁棒性,我们一般用均值代替,也就是 这显著提高了泛化性,采样路径可以改变同state,不同action的动作价值
3.3 PER
用TD Error来衡量一个经验的价值(目标值减去当前预测值的绝对值),使用SumTree使得TD Error越大的经验越容易被抽中,显著加快了收敛
3.4 Distributional RL
C51预测一个柱状图分布,也就是人为取51个固定端点,用softmax预测各个区间的概率而非只预测均值,这提高了信息量,增强了鲁棒性
3.5 n-step Learning
与多步SARSA一致,将原本扩展为n步,平衡了方差和偏差
3.6 noisy nets
舍弃,这种依赖人工调节超参数,真正意义上的平衡了探索和利用: 1.自动退火,逐渐减少探索 2.连续探索,而非随机探索
4.代码实践
我们采用CartPole环境,此环境目标是通过左右移动使得小车上的木杆保持竖直
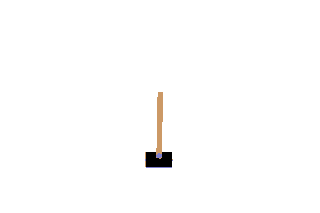 done的条件是车子偏离初始位置太远,或者杆子倾斜角度太大,或者坚持超过200帧
(日后更新)