3.1 MP#
我们一般使用元组⟨S,P⟩来描述MP,其中S是有限数量的状态集合,P是状态转移矩阵
假设共有n个离散的状态,此时:
S={s1,…,sn}
P= P(s1∣s1)⋮P(sn∣s1)⋯⋱⋯P(sn∣s1)⋮P(sn∣sn)3.2 MRP#
我们在MP的基础上加上奖励函数r与折扣因子γ,那我们就得到了MRP
一般由四元组⟨S,P,r,γ⟩来定义,其中
r为奖励函数,r(s)指在s状态下获得奖励的期望,
γ为折扣因子,引入它可以确保价值收敛,范围为[0,1),可以通过调整使之更关注长期/短期利益
3.2.1 回报#
我们定义从第t时间步开始的所有奖励的衰减之和定义为回报Gt(return)
Gt=Rt+γRt+1+γ2Rt+2+⋯=∑k=0∞γkRt+k
其中,Rt表示t时间步时获得的奖励
3.2.2 价值函数#
我们把一个时间步的回报的期望定义为价值
所有状态的价值组成了价值函数,(输入为某个state,输出为某个价值),定义为
V(s)=E[Gt∣St=s]
而,
V(s)=E[Gt∣St=s]=E[Rt+γRt+1+γ2Rt+2+⋯∣St=s]=E[Rt+γ(Rt+1+γRt+2)+⋯∣St=s]=E[Rt+γV(St+1)∣St=s]故我们可以得到:
V(s)=r(s)+γ∑s′∈SP(s′∣s)V(s′)
这就是大名鼎鼎的贝尔曼方程
我们整理所有共t个状态,组成列向量
得到矩阵形式的贝尔曼方程:
V=R+γPV
V(s1)V(s2)⋮V(st)=r(s1)r(s2)⋮r(st)+γP(s1∣s1)P(s1∣s2)⋮P(s1∣s1)P(s2∣s1)P(s2∣s2)⋮P(s2∣s1)⋯⋯⋱⋯P(st∣s1)P(st∣s2)⋮P(st∣s1)V(s1)V(s2)⋮V(st)故移项解得:
V=(I−γP)−1R
3.3 MDP#
总算推进到了MDP
MP与MRP都没有“动作”“策略”的参与,本质上是一个自己运行,无干预的系统
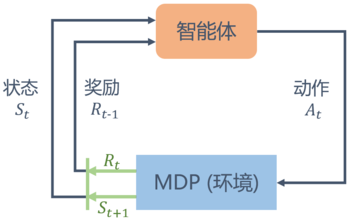
如果有一个外界的“刺激”可以改变这个随机过程(加入智能体的”动作”),就得到了MDP
我们可以把MDP记为一个五元组:
⟨S,A,P,r,γ⟩
其中A为动作集合
在这种情况下,我们不把P记作一个概率分布矩阵,而是记作一个状态转移函数,原因有二:
1)记作概率分布矩阵不可行,因为引入了不同的动作,而每一个动作都具有自己的概率分布矩阵,故只能记作一个三阶张量
2)状态集合非有限时,仍可以记作状态转移函数,说明状态转移函数更为普遍
agent与环境相互交互的过程大致如下:
3.3.1 策略(policy)#
智能体的策略(Policy)通常用字母π表示。策略π(a∣s)=P(At=a∣St=s)是一个函数,表示在输入状态情况下采取动作的概率。
在 MDP 中,由于马尔可夫性质的存在,策略只需要与当前状态有关,不需要考虑历史状态。
3.3.2 状态价值函数Vπ(s)#
与MRP定义类似,状态价值函数被定义为基于策略π的回报的期望,定义为:
Vπ(s)=Eπ[Gt∣St=s]
3.3.3 动作价值函数Qπ(s,a)#
与MRP不同的是,我们额外定义一个基于π的函数,定义为:
Qπ(s,a)=Eπ[Gt∣St=s,At=a]
状态价值函数和动作价值函数之间的联系:
Vπ(s)=∑a∈Aπ(a∣s)Qπ(s,a)
其意义是显然的,不过多解释
当然,还有Q的计算式:
Qπ(s,a)=r(s,a)+γ∑s′∈SP(s′∣s,a)Vπ(s′)
3.3.4 贝尔曼期望方程#
Vπ(s)=E[R(s)+γVπ(St+1∣St=s)]=a∈A∑π(a∣s)(r(s,a)+γs′∈S∑P(s′∣s,a)Vπ(s′))Qπ(s,a)=E[R(s,a)+γQπ(St+1,At+1∣St=s,At=a)]=r(s,a)+γs′∈S∑P(s′∣s,a)a′∈A∑π(a′∣s)Qπ(s′,a′)3.6 最优策略#
我们定义π>π′当且仅当∀s∈S,Vπ(s)≥Vπ′(s)
于是在有限状态和动作集合的 MDP 中,至少存在一个策略比其他所有策略都好或者至少存在一个策略不差于其他所有策略,这个策略就是最优策略(optimal policy)。最优策略可能有很多个,我们都将其表示为π∗(s)。
由此,我们可以定义最优状态价值函数V∗(s)与最优动作价值函数Q∗(s,a)
V∗(s)=maxπVπ(s),∀s∈S
Q∗(s,a)=maxπQπ(s,a),∀s∈S,∀a∈A
为了使Q最大,我们要使得之后的每个选择都选择最优价值,即:
Q∗(s,a)=r(s,a)+γ∑s′∈SP(s′∣s,a)V∗(s′)=r(s,a)+γ∑s′∈SP(s′∣s,a)maxa′∈AQ∗(s′,a′)
同样的,最优的状态价值出自最优的动作,即:
V∗(s)=maxa∈AQ∗(s,a)=maxa∈A(r(s,a)+γ∑s′∈SP(s′∣s,a)V∗(s′))
我们把
Q∗(s,a)=r(s,a)+γ∑s′∈SP(s′∣s,a)maxa′∈AQ∗(s′,a′)
与
V∗(s)=maxa∈A(r(s,a)+γ∑s′∈SP(s′∣s,a)V∗(s′))
称作贝尔曼最优方程
 羽落天青 | Uke's Blog