我们简单介绍三种算法,并附上代码实践
1 TD#
我们给出下面的式子:
Vπ(s)=Eπ[Gt∣St=s]=Eπ[ri+γGt+1∣St=s]=Eπ[rt+γVπ(St+1)∣St=s]最后一个等号是因为全期望公式
回顾MDP中的蒙特卡洛算法,我们需要采样完一整条路径,再采用上式的第一行进行增量更新,形式类似:
Vπ(St)←Vπ(St)+α[Gt−Vπ(St)]
其中,α=N(s)1或最好至少有∑α→∞且∑α2<∞
采样一条路径耗时长,方差大,我们可以采用第三行来进行增量更新,也就是:
Vπ(St)←Vπ(St)+α[rt+γVπ(St+1)−V(St)]
这便是强化学习中的TD方法
我们发现,这大大降低了随机性,也就降低了方差,但同时,自举式的更新导致这是一种有偏估计(在离线策略或函数逼近时将不一定能收敛到全局最优)
2 SARSA#
我们尝试使用类似策略迭代的方式来解决这个问题
我们已经可以使用TD进行策略评估,那我们该如何进行策略提升呢?
那么可以有:
Q(st,at)←Q(st,at)+α[rt+γQ(st+1,at+1)−Q(st,at)]
然后每次更新选择argmaxaQ(s,a)即可
但是,这样做存在问题,也就是如何平衡探索与利用?
我们是采样更新,而非像DP那样挑选每个动作,也许有一些动作从来没更新
于是,我们定义
π(a∣s)={∣A∣ϵ+1−ϵ,∣A∣ϵ,if a=argmaxaQ(s,a)else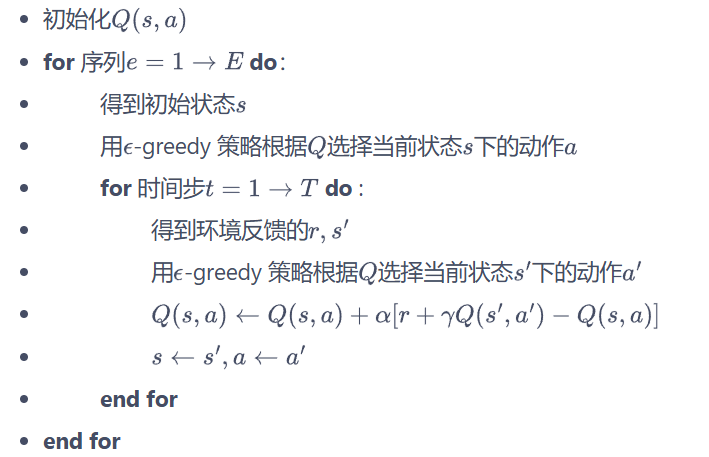 这个算法与s,a,r,以及s’,a’有关,因此得名sarsa
3 多步 Sarsa#
Q(st,at)←Q(st,at)+α[rt+γQ(st+1,at+1)+γ2Q(st+2,at+2)+⋯+γnQ(st+2,at+2)−Q(st,at)]
这便是n步sarsa算法的更新方式,可以在一定程度上中和这种自举的算法的偏差
4 Q-learning#
Q(st,at)←Q(st,at)+α[rt+γmaxaQ(st+1,a)−Q(st,at)]
这是一种离线策略算法,直接估计的是贝尔曼最优方程
5 Dyna-Q#
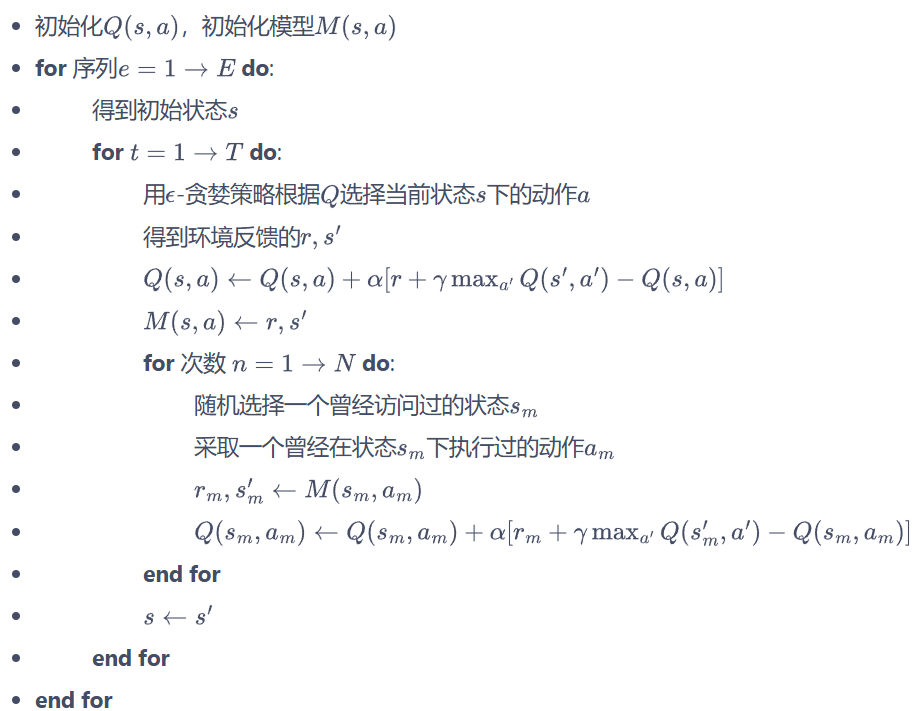
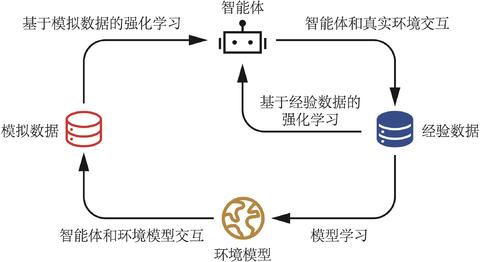
之前介绍的都是无模型的算法,也就是不对环境进行建模的算法,而Dyna-Q会进行Q-planning
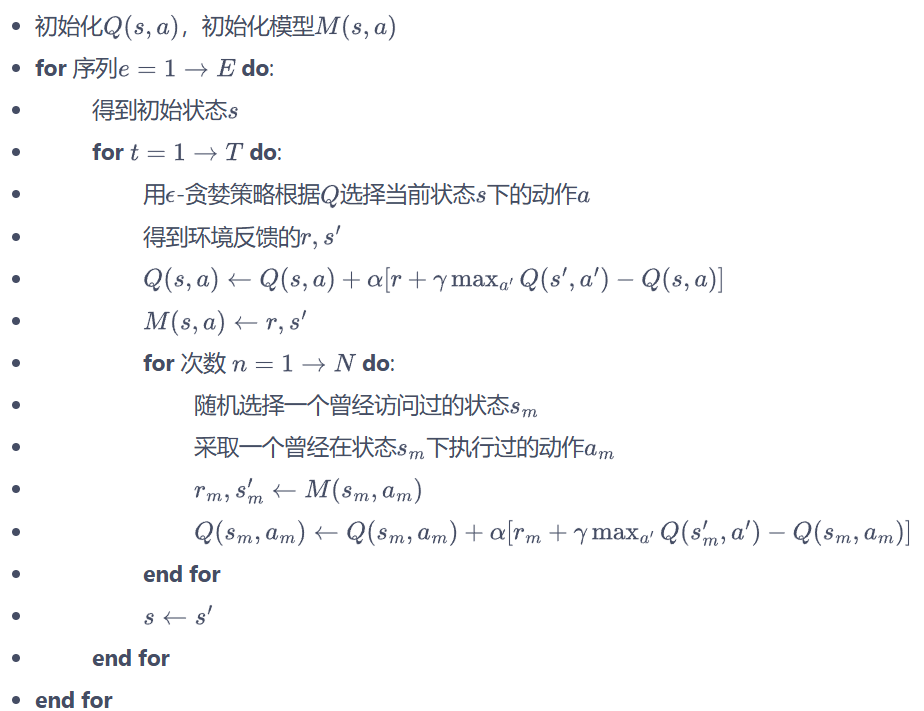 这里的M也就是模型
书中的算法是执行在确定性环境中,那么M就是一个简单的记忆模型,而非推测模型
Dyna-Q好在哪里?
每一次采样,通过Q-planning可以生成n个假采样并更新数据,更新效率极高,在取样困难等场景非常管用
 羽落天青 | Uke's Blog