 羽落天青 | Uke's Blog
884 字
4 分钟
MAB
1.
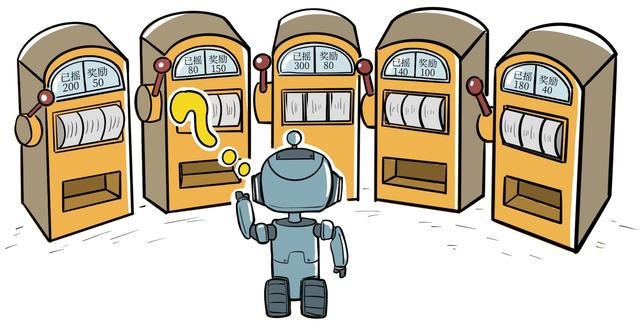
首先,基于整个问题给出一个形式化的描述: 多臂老虎机问题不存在,也就可以建模为一个元组,其中:
- 为动作集合
- 为奖励概率分布
多臂老虎机的优化目标为最大化一段时间步内累计的奖励,也即:
我们将其转换为最小化懊悔(cumulative regret) 我们将懊悔定义为:
其中,
关于期望奖励估值的伪代码:
对于,先初始化计数器 和初始化奖励估计值 选取某个拉杆,该动作记为 得到奖励 更新计数器++; 更新奖励估计值
这一流程采取增量式更新,时间,空间复杂度均为O(1)(推导容易) 接下来写一个实现伯努利分布多臂老虎机的类
import numpy as np
import matplotlib.pyplot as plt
class BNLbandit:
def __init__ (self,k:int)-> None:
self.K=k
self.probs=np.random.uniform(0,1,size=k)
self.max_idx=np.argmax(self.probs)
self.max_prob=self.probs[self.max_idx]
def step(self,action):
if np.random.rand()<self.probs[action]:
return 1
else:
return 0
class Solver:
def __init__(self,bandit:BNLbandit) -> None:
self.bandit=bandit
self.counts=np.zeros(bandit.K)
self.regret=0.
self.regrets=[]
self.actions=[]
def run_one_step(self)->int:
raise NotImplementedError
def update_regret(self,action:int):
self.regret+=self.bandit.max_prob-self.bandit.probs[action]
self.regrets.append(self.regret)
def run(self,n_steps:int):
for _ in range(n_steps):
action=self.run_one_step()
self.update_regret(action)
self.actions.append(action)
self.counts[action]+=1
def plot_results(axes,solvers,solver_names):
for idx,solver in enumerate(solvers):
time_list=range(len(solver.regrets))
axes.plot(time_list,solver.regrets,label=solver_names[idx],alpha=0.8)
axes.set_xlabel("Time steps")
axes.set_ylabel("Cumulative regrets")
axes.legend()2.
很经典的,我们需要找到探索与利用 的平衡点
接下来一个一个算法进行分析
每次以的概率进行探索,以的概率进行利用,即:
当然,我们可以令随时间衰减,但是我们始终得到的是相对精确的期望,故应该保证不为0
首先需要应用霍夫丁不等式:(大概大二上会学)
代入
令上式中
代表不确定性度量。 记
则
当很小的时候,这件事情大概率发生。 故我们令期望奖励上界为
解得
此时,
其中,c为超参数,方便控制不确定比重
汤普森采样,顾名思义,猜测概率分布,通过每个时间步采样其概率取 一般采用分布,分布在上,其中概率密度函数为:
是归一化参数,为上部函数在上的积分值
3.
最后,把这3种算法对应的solver以及main贴一下,看一下可视化效果
class EpsilonGreedy(Solver):
def __init__(self,bandit:BNLbandit,epsilon:float=0.01,init_prob:float=1.0):
super(EpsilonGreedy,self).__init__(bandit)
self.epsilon=epsilon
self.estimate=np.array([init_prob]*bandit.K)
def run_one_step(self):
if np.random.rand()<self.epsilon:
k=np.random.randint(0,self.bandit.K)
else:
k=np.argmax(self.estimate)
r=self.bandit.step(k)
self.estimate[k]+=1./(self.counts[k]+2)*(r-self.estimate[k])#更稳定,否则一旦第一次roll出0,直接报废
return k
class DacayingEpsilonGreedy(EpsilonGreedy):
def __init__(self,bandit:BNLbandit,epsilon:float=0.1,init_prob:float=1.0):
super(DacayingEpsilonGreedy,self).__init__(bandit,epsilon,init_prob)
def run_one_step(self):
self.epsilon=1/(len(self.regrets)+1)
return super(DacayingEpsilonGreedy,self).run_one_step()
class UCB(Solver):
def __init__(self, bandit: BNLbandit,ceof:float=1.0,init_prob:float=1.0) -> None:
super(UCB,self).__init__(bandit)
self.ceof=ceof
self.estimate=np.array([init_prob]*bandit.K)
self.tot_count=0
def run_one_step(self)->int:
self.tot_count+=1
ucb=self.estimate+self.ceof*np.sqrt(np.log(self.tot_count)/2/(self.counts+1))
k=np.argmax(ucb)
r=bandit.step(k)
self.estimate[k]+=(r-self.estimate[k])/(1+self.counts[k])
return k
class TompsonSampling(Solver):
def __init__(self, bandit: BNLbandit) -> None:
super(TompsonSampling,self).__init__(bandit)
self.alpha=np.ones(bandit.K)
self.beta=np.ones(bandit.K)
self.tot_count=0
def run_one_step(self) -> int:
self.estimate=np.random.beta(self.alpha,self.beta)
k=np.argmax(self.estimate)
r=bandit.step(k)
if r==1:
self.alpha[k]+=1
else:
self.beta[k]+=1
return k
if __name__=="__main__":
np.random.seed(1)
bandit=BNLbandit(k=10)
print(f"max={bandit.max_prob}")
print("The probabilities of the arms are:",bandit.probs)
plt.style.use('seaborn-v0_8-darkgrid')
fig,ax=plt.subplots(2,2,figsize=(12,8))
plt.suptitle(f"{bandit.K}-armed bandit",fontsize=20)
epsilons=[0.001,0.01,0.05,0.1,0.2,0.5]
epsilon_solvers=[EpsilonGreedy(bandit,epsilon) for epsilon in epsilons]
for solver in epsilon_solvers:
solver.run(5000)
epsilon_names=[f"Epsilon-Greedy epsilon={epsilon}" for epsilon in epsilons]
plot_results(ax[0,0],epsilon_solvers,epsilon_names)
decaying_epsilon_solver=DacayingEpsilonGreedy(bandit)
decaying_epsilon_solver.run(5000)
plot_results(ax[0,1],[decaying_epsilon_solver],["Decaying Epsilon-Greedy"])
UCB_Solver=UCB(bandit)
UCB_Solver.run(5000)
plot_results(ax[1,0],[UCB_Solver],["UCB"])
Tompson_Solver=TompsonSampling(bandit)
Tompson_Solver.run(5000)
plot_results(ax[1,1],[Tompson_Solver],["Tompson_Sampling"])
plt.savefig("MAB.png")
plt.show()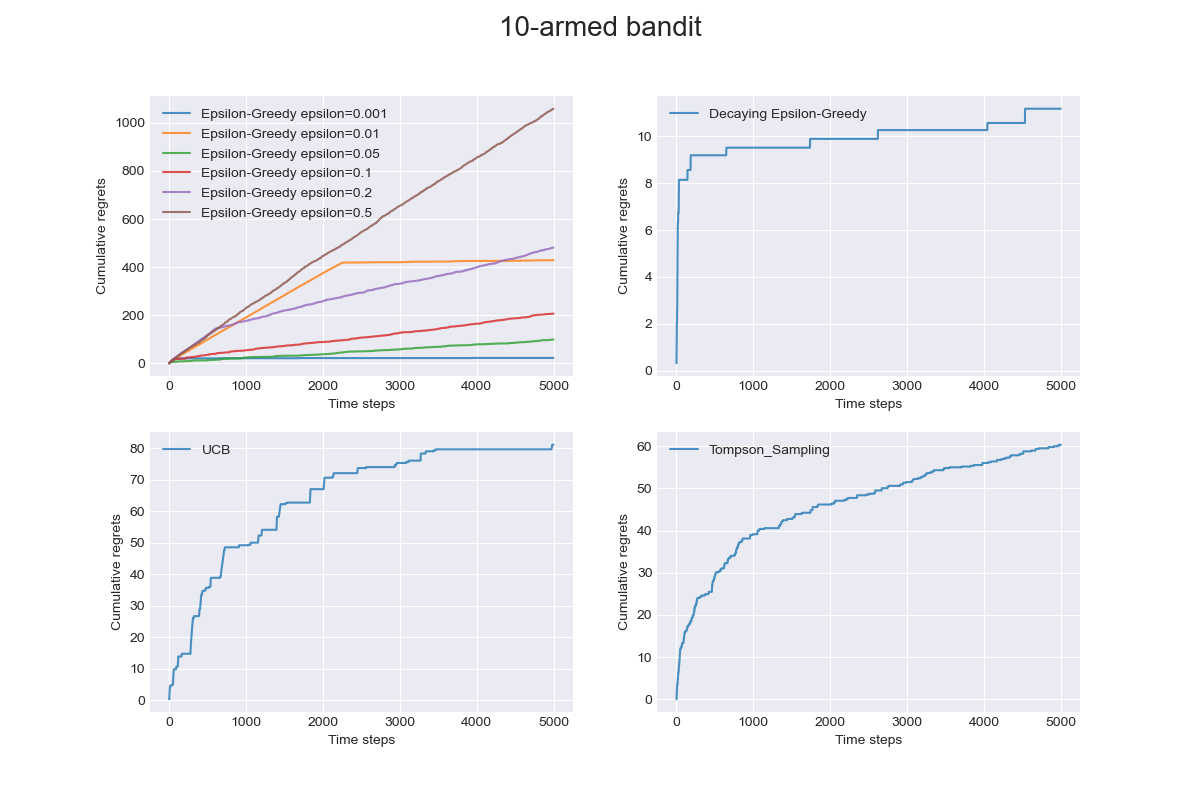
进一步的,我们引入上下文,可以得到上下文老虎机CB,动作可以影响决策,可以得到MDP,无法观测到真实的state,可以得到POMDP,这些文章我也许后续会更新